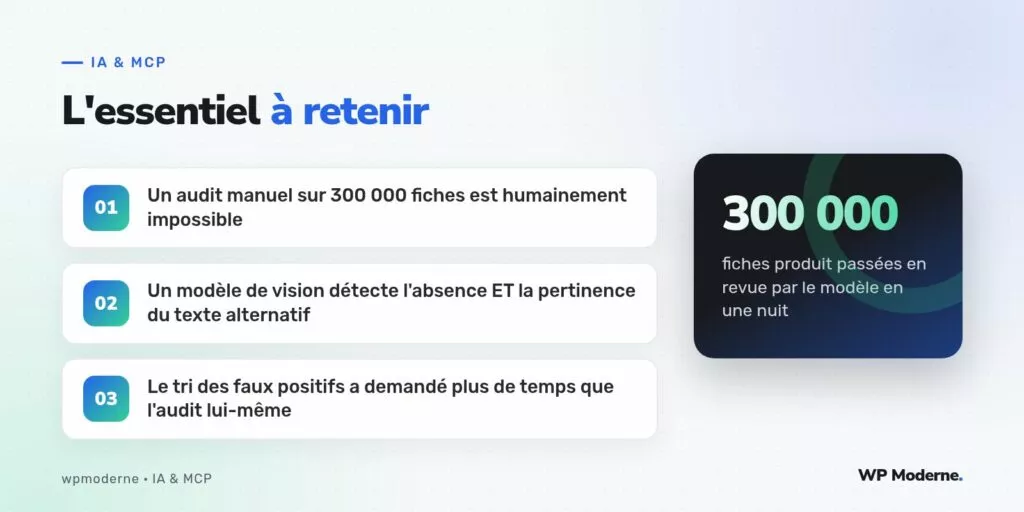
Trois cent mille. C’est le nombre de fiches produit que compte le catalogue de la marketplace Kadolib, un volume qui rend tout simplement impensable une vérification manuelle de la présence et de la pertinence d’un texte alternatif sur chaque image. L’audit d’accessibilité commandé à la suite d’une mise en demeure a donc dû passer par un traitement automatisé, avec un modèle de vision chargé de repérer les manques.
La tâche paraissait simple sur le papier : lister les images sans attribut alt, ou avec un attribut vide, puis générer une proposition de texte alternatif à partir de l’image elle-même. Dans les faits, le travail le plus long n’a pas été l’audit en tant que tel, réalisé en une nuit sur l’ensemble du catalogue, mais le tri des résultats une fois produits.
La mécanique de l’audit
Un script a d’abord parcouru l’export du catalogue pour isoler les images sans texte alternatif exploitable, qu’il s’agisse d’une absence totale, d’une valeur vide ou d’un texte manifestement généré automatiquement par la plateforme d’origine (« image1.jpg », « DSC_04213 »). Chaque image ainsi repérée a ensuite été soumise à un modèle de vision, avec une consigne demandant une description factuelle en une phrase, orientée vers l’usage d’un lecteur d’écran plutôt que vers une description artistique.
Le volume traité a nécessité un séquencement par lots de mille images, avec des pauses entre les lots pour respecter les limites de débit de l’API utilisée, et une reprise automatique en cas d’erreur temporaire sur un lot. L’ensemble du catalogue a été traité en une nuit, un résultat qui aurait représenté plusieurs mois de travail pour une personne vérifiant chaque image à la main.
Les faux positifs, plus nombreux que prévu
La première surprise a concerné les images déjà pourvues d’un texte alternatif techniquement présent, mais sans rapport avec l’image affichée : un modèle de canapé illustré avec pour texte alternatif hérité « bannière promotion été », copié-collé lors d’une migration de plateforme des années plus tôt. Le script initial ne cherchait que l’absence de texte, pas son inexactitude, et ces cas sont passés entre les mailles du premier passage.
Une deuxième catégorie de faux positifs est apparue sur les images purement décoratives, comme des séparateurs visuels ou des icônes de garantie déjà expliquées par le texte environnant : le modèle générait pour elles des descriptions détaillées et inutiles, alors que la bonne pratique d’accessibilité recommande un attribut alt vide pour ce type d’image, précisément pour que le lecteur d’écran les ignore.
Le tri appliqué en seconde passe
- Comparer la description générée par le modèle au texte alternatif existant pour repérer les incohérences flagrantes plutôt que les seules absences.
- Faire classer par le modèle lui-même chaque image en trois catégories : informative, décorative, ou ambiguë à vérifier par un humain.
- N’appliquer automatiquement les descriptions générées que sur la catégorie « informative », avec un score de confiance suffisant.
- Constituer une liste des cas « ambigus » pour une relecture manuelle, réduite à quelques milliers d’images plutôt que trois cent mille.
Ce que le modèle a bien fait
- Décrire correctement la couleur, la forme générale et le type de produit dans la grande majorité des cas informatifs.
- Repérer les logos de marque et les nommer quand ils figuraient déjà dans le nom du produit associé.
- Signaler lui-même son incertitude sur les images de mauvaise qualité, plutôt que d’inventer une description assurée.
Un audit d’accessibilité assisté par un modèle ne doit jamais se limiter à un rapport de conformité binaire : le vrai travail commence quand on trie ce que le modèle a bien vu de ce qu’il a mal interprété.
Ce que l’audit n’a pas couvert
Le passage automatisé n’a traité que les images de fiches produit, à l’exclusion des images intégrées dans les pages de contenu éditorial (guides d’achat, articles de blog), qui ont fait l’objet d’un audit séparé, plus classique et manuel compte tenu de leur volume nettement plus restreint. La question de la performance du moteur de recherche interne de la marketplace, souvent citée en même temps que l’accessibilité, restait hors du périmètre de cette mission.
En résumé
Sur un catalogue de cette taille, un modèle de vision n’a pas remplacé le jugement humain sur l’accessibilité, il l’a rendu applicable à une échelle qui aurait été impossible autrement. La discipline à adopter n’est pas de faire confiance au premier passage automatisé, mais de prévoir dès le départ une étape de tri des faux positifs, souvent plus longue que l’audit lui-même mais bien moins longue qu’un audit entièrement manuel.