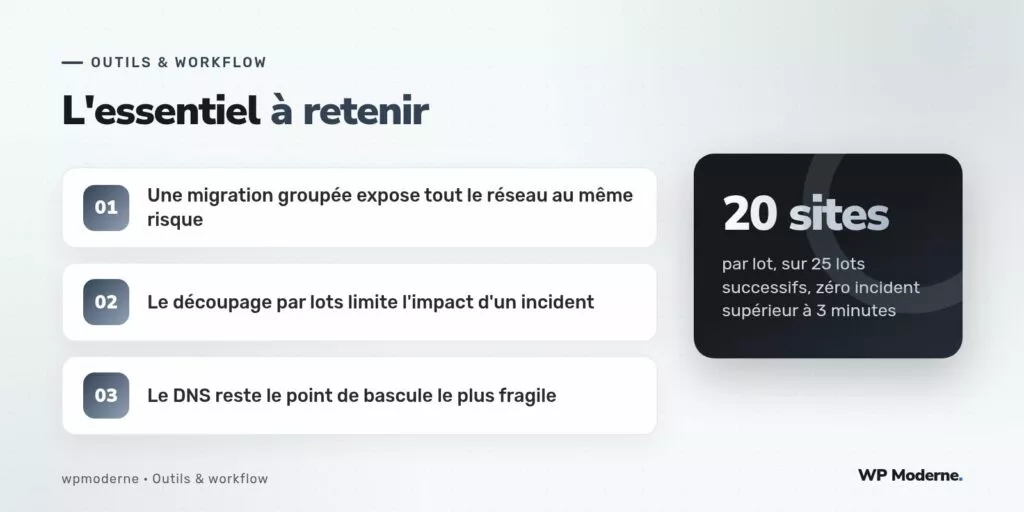
Comment migrer cinq cents sites WordPress de collectivités d’un hébergeur vers un autre sans qu’aucun administré ne remarque la moindre coupure ? La tentation classique consiste à préparer la nouvelle infrastructure, basculer tout le réseau en une seule nuit, et espérer que rien ne casse. Nous avons écarté cette approche dès la phase de cadrage : sur un parc de cette taille, une migration groupée expose l’intégralité du réseau au même risque au même instant, et le moindre problème imprévu — un module PHP manquant, une configuration réseau incompatible — devient immédiatement un incident à l’échelle de cinq cents sites plutôt que d’un seul.
La méthode retenue s’est construite autour d’un principe simple : découper la migration en lots suffisamment petits pour qu’un incident sur un lot n’affecte jamais les lots suivants, et suffisamment nombreux pour que l’apprentissage tiré des premiers lots améliore la fiabilité des suivants.
Choisir la taille et la composition des lots
Vingt sites par lot, migrés sur des créneaux distincts espacés de deux à trois jours, ont constitué notre unité de découpage. Ce chiffre n’est pas arbitraire : il correspond au nombre de sites qu’une équipe de deux personnes peut vérifier manuellement un par un en une demi-journée après bascule, sans se reposer uniquement sur des contrôles automatisés. Chaque lot mélangeait volontairement des profils différents — petites communes à trafic faible et intercommunalités à trafic plus soutenu — pour que les premiers lots de test représentent fidèlement la diversité du réseau complet, plutôt que de commencer par les cas les plus simples uniquement.
Le DNS, point de bascule le plus fragile
La bascule elle-même repose sur la modification des enregistrements DNS de chaque site vers la nouvelle infrastructure. C’est l’étape la plus délicate : un TTL DNS mal anticipé peut laisser une partie des visiteurs continuer à interroger l’ancienne infrastructure pendant plusieurs heures après la bascule. Une semaine avant le début de la migration du réseau, le TTL de chaque zone DNS concernée a été abaissé à trois cents secondes, contre les vingt-quatre heures habituelles, pour garantir une propagation rapide au moment de la bascule réelle.
Vérifier avant, pendant et après chaque lot
Avant la bascule d’un lot
- Synchronisation complète des fichiers et de la base de données vers la nouvelle infrastructure, suivie d’une comparaison de hash sur un échantillon de fichiers pour détecter toute corruption de transfert.
- Test de chaque site sur la nouvelle infrastructure via une modification temporaire du fichier
hostslocal, sans toucher au DNS public, pour valider le rendu avant l’exposition réelle.
Pendant la bascule
for domaine in $(cat lot-12-domaines.txt); do
  echo "Bascule DNS pour $domaine"
  ovh-cli domain record update --zone "$domaine" --type A --target "$NOUVELLE_IP"
  sleep 2
done
Après la bascule
- Contrôle automatisé du code HTTP renvoyé par chaque site du lot, toutes les trente secondes pendant les deux heures suivant la bascule.
- Vérification manuelle du fonctionnement des formulaires de contact et des espaces de téléservices, qui ne remontent pas toujours d’erreur HTTP visible en cas de dysfonctionnement.
Ce qui a failli mal tourner sur le lot 7
Sur le septième lot, un site utilisait une extension de téléservice qui codait en dur l’ancienne adresse IP du serveur dans sa configuration de rappel de webhook, plutôt que de s’appuyer sur le nom de domaine. La bascule DNS n’a donc rien changé côté navigateur des administrés, mais les notifications de dépôt de dossier vers les services internes de la commune ont cessé de fonctionner silencieusement pendant quarante minutes, jusqu’à ce que le contrôle manuel des téléservices le détecte. Ce cas isolé a conduit à ajouter, pour tous les lots suivants, une vérification systématique des configurations d’extension pointant vers une adresse IP plutôt qu’un nom de domaine avant chaque bascule.
Un découpage en petits lots ne réduit pas le nombre d’incidents possibles sur une migration de cette ampleur ; il réduit leur portée et transforme chaque incident en leçon exploitable pour les lots suivants.
Notre méthode, en résumé chiffré
Vingt-cinq lots de vingt sites, étalés sur environ deux mois, avec un incident détecté (le cas du lot 7) traité en moins de quarante minutes et sans impact perceptible pour les administrés sur les autres lots. Le TTL DNS abaissé en amont et les vérifications systématiques avant, pendant et après chaque bascule ont constitué le socle de cette fiabilité, bien plus que la sophistication de l’infrastructure cible elle-même.