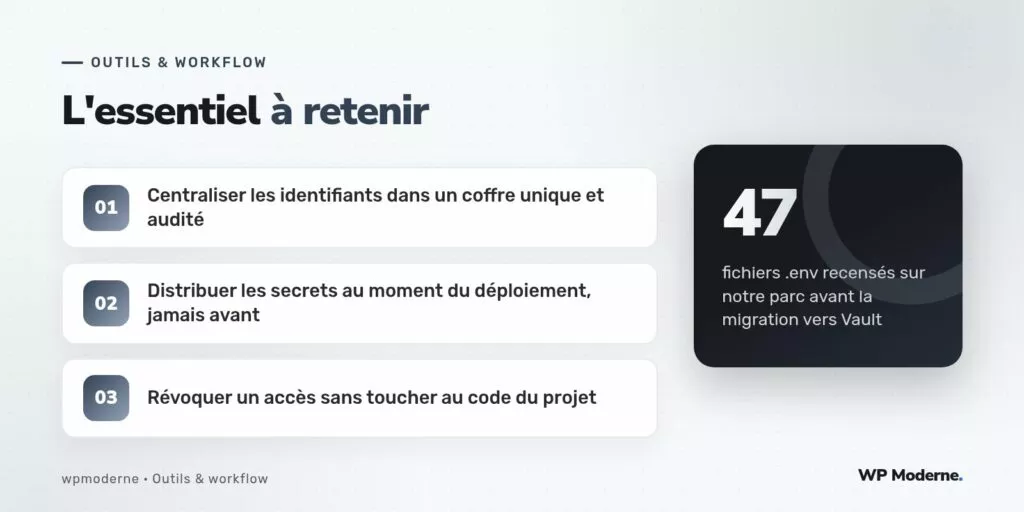
Quarante-sept : c’est le nombre de fichiers .env différents que nous avons recensés en auditant notre parc de sites clients, chacun contenant des identifiants de base de données, des clés d’API tierces et parfois des mots de passe SFTP en clair, dispersés sur des serveurs, des postes de développeurs et quelques dépôts Git où ils n’auraient jamais dû atterrir.
Cette dispersion posait un problème simple à énoncer et pénible à résoudre après coup : quand un développeur quittait l’équipe, personne ne savait avec certitude à quels secrets il avait eu accès, ni s’il fallait tous les régénérer. Nous avons donc centralisé la gestion de ces identifiants dans un coffre-fort de secrets, HashiCorp Vault.
Ce que Vault change concrètement
Vault stocke les secrets de façon chiffrée et distribue un accès temporaire et audité à chaque secret, plutôt que de laisser un identifiant statique circuler indéfiniment dans des fichiers de configuration. Trois apports ont justifié la migration pour notre parc :
- Un point unique de vérité pour chaque identifiant, avec un historique complet de qui y a accédé et quand.
- La possibilité de révoquer un accès en une commande, sans avoir à modifier le code ni redéployer chaque site concerné.
- Des secrets dynamiques pour certains services, générés à la demande avec une durée de vie limitée, plutôt qu’un mot de passe fixe valable indéfiniment.
Organiser le coffre par client et par environnement
La structure retenue sépare les secrets par client, puis par environnement, pour qu’un accès accordé à un projet ne donne jamais de visibilité sur un autre :
secret/
├── client-a/
│   ├── production/
│   │   ├── db
│   │   └── api-paiement
│   └── recette/
│       └── db
└── client-b/
    └── production/
        └── db
Distribuer les secrets au moment du déploiement
Le point clé de cette architecture : les secrets ne sont jamais stockés sur le serveur en dehors du moment où ils sont utilisés. Le script de déploiement interroge Vault juste avant de démarrer les services, récupère les identifiants nécessaires, les injecte en variables d’environnement, puis les efface de tout fichier temporaire :
#!/bin/bash
export VAULT_ADDR="https://vault.interne.agence.fr:8200"
export VAULT_TOKEN=$(cat /etc/vault-token-deploiement)

DB_PASSWORD=$(vault kv get -field=password secret/client-a/production/db)

# Injection dans le fichier de configuration WordPress généré à la volée
wp config set DB_PASSWORD "$DB_PASSWORD" --path=/var/www/client-a

unset DB_PASSWORD
Cette approche évite qu’un identifiant traîne en clair dans l’historique bash d’un serveur ou dans un fichier oublié après un déploiement manuel.
Gérer les accès par équipe et par rôle
Vault permet de définir des politiques d’accès précises, attachées à des jetons ou des comptes nommés. Sur notre parc, trois profils suffisent dans la grande majorité des cas :
- Un profil « développement », qui ne peut lire que les secrets de l’environnement de recette d’un client donné.
- Un profil « déploiement automatisé », utilisé exclusivement par les pipelines CI, avec un accès en lecture seule limité au strict nécessaire.
- Un profil « administration », réservé à deux personnes de l’équipe, seul habilité à modifier les secrets de production.
Ce que cette centralisation n’a pas résolu
Vault sécurise le stockage et la distribution des secrets, mais il ne protège pas contre une mauvaise pratique en amont : un développeur qui copie un secret récupéré depuis Vault dans un fichier de notes personnel reproduit exactement le problème que le coffre devait résoudre. La discipline d’équipe reste indispensable, l’outil ne fait que réduire les occasions d’erreur.
Un coffre-fort ne sert à rien si la clé finit collée sur un post-it à côté.
En résumé
Passer de quarante-sept fichiers .env dispersés à un coffre centralisé a pris plusieurs semaines de migration progressive, client par client, mais a supprimé un point de fragilité que nous avions fini par considérer comme normal. Aujourd’hui, révoquer l’accès d’un ancien collaborateur prend une commande, pas un audit de plusieurs jours.