U+00E9 d’un côté, U+0065 U+0301 de l’autre : deux façons parfaitement valides de représenter la lettre « é » en Unicode. La première, dite forme composée (NFC), utilise un seul point de code. La seconde, dite forme décomposée (NFD), combine un « e » et un accent aigu combinant. Un navigateur les affiche de façon rigoureusement identique. Un serveur, lui, les traite comme deux chaînes de caractères différentes.
Ce détail d’encodage, invisible à l’œil, a suffi à faire naître deux articles distincts sur un site utilisant un import automatisé depuis un tableur : le titre saisi sur un Mac, où macOS normalise volontiers en NFD, générait un slug différent de celui obtenu en retapant le même titre sous un clavier Windows, qui produit plutôt du NFC. Résultat, deux URL, un seul contenu, publiées à quelques semaines d’intervalle sans que personne ne s’en aperçoive.
Comment WordPress construit le slug
La fonction sanitize_title() transforme un titre en slug en retirant les caractères spéciaux et en translittérant les accents grâce à remove_accents(). Ces deux fonctions opèrent caractère par caractère sur la chaîne telle qu’elle est reçue : si la chaîne arrive déjà décomposée en NFD, la translittération peut se comporter différemment que sur une forme NFC, notamment parce que remove_accents() repose sur une table de correspondance construite pour des caractères composés.
Dans le cas observé, la forme NFC donnait bien le slug attendu, « evenement-a-la-mediatheque ». La forme NFD, elle, laissait passer un caractère combinant que la table de correspondance ne reconnaissait pas, produisant un slug légèrement différent une fois les caractères non reconnus remplacés par des tirets superflus.
Repérer le doublon dans la base
Le symptôme le plus visible reste le rapport de couverture de Search Console, qui signale un « Doublon, Google a choisi un canonique différent de celui de l’utilisateur » entre les deux URL. Une requête SQL directe permet de confirmer l’hypothèse d’un problème d’encodage avant de corriger quoi que ce soit :
SELECT ID, post_title, post_name
FROM wp_posts
WHERE post_status = 'publish'
AND post_title LIKE '%vnement%mdiathque%';
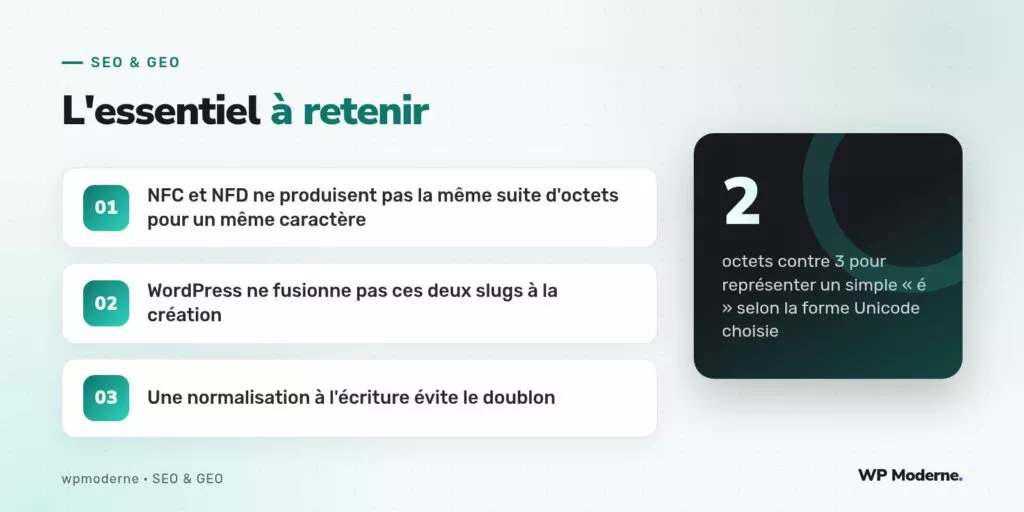
Comparer les octets des deux post_name avec un outil comme xxd en ligne de commande met en évidence la différence : une séquence c3 a9 (NFC) sur l’un, une séquence 65 cc 81 (NFD) sur l’autre, là où l’œil ne voit qu’un « é » identique dans les deux cas.
Empêcher la récidive à l’écriture
La correction la plus fiable consiste à normaliser systématiquement les titres en amont, avant qu’ils n’atteignent sanitize_title(), en s’appuyant sur la classe PHP Normalizer de l’extension intl, disponible sur la quasi-totalité des hébergements mutualisés récents :
- Convertir tout titre entrant en forme NFC avec
Normalizer::normalize( $titre, Normalizer::FORM_C )avant l’enregistrement du contenu. - Appliquer ce filtre au niveau du hook
wp_insert_post_data, qui intercepte le titre juste avant son écriture en base. - Auditer une bonne fois les titres existants pour repérer d’éventuelles formes NFD déjà enregistrées, avant qu’un nouvel import ne les duplique.
Corriger un doublon déjà publié
Une fois le doublon confirmé, une redirection 301 de la version NFD vers la version NFC — posée via une règle RewriteRule ciblant précisément les octets concernés — régule la situation sans toucher au contenu original. Supprimer purement l’article en double revient à perdre l’historique d’indexation qui lui est propre ; la redirection conserve ce qui peut l’être.
Un caractère qui se ressemble à l’écran ne se ressemble pas forcément en octets. C’est justement ce que les outils de comparaison humaine ne montrent jamais.
Pour aller plus loin
Ce type de doublon reste rare, mais il touche en priorité les sites qui reçoivent du contenu par import automatisé, copié-collé depuis des sources hétérogènes, ou saisi par plusieurs rédacteurs sur des systèmes d’exploitation différents. Normaliser systématiquement les titres à l’écriture coûte une ligne de code ; le diagnostiquer après coup, lui, demande de comparer des octets invisibles à l’œil nu.