« Découverte, actuellement non indexée. » Ce libellé exact apparaît dans le rapport de couverture de Search Console, onglet Pages, quand une URL a été repérée par Google — via le sitemap ou un lien — mais que le moteur n’a pas encore jugé utile de l’explorer. Contrairement à « Exploré, actuellement non indexé », l’exploration elle-même n’a pas eu lieu : Google connaît l’existence de l’URL sans lui avoir consacré la moindre requête.
Sur un article de blog technique publié un mardi matin, ce statut peut persister trois à quatre semaines sans qu’aucune erreur ne remonte ailleurs dans Search Console. Le sitemap est valide, la page répond en 200, aucun noindex ne traîne dans le code source. Et pourtant rien ne bouge. La cause se trouve presque toujours dans les signaux internes du site, pas dans un problème serveur.
Ce que ce statut ne signifie pas
Il ne s’agit ni d’une pénalité manuelle, ni d’un blocage technique. Google explore chaque jour un volume de pages proportionnel à ce qu’il appelle en interne le budget d’exploration, une notion documentée par Google elle-même dans son guide sur la gestion du budget d’exploration des grands sites. Pour un blog de quelques centaines de pages, ce budget n’est en général pas le facteur limitant : le problème est plutôt que la page neuve n’envoie aucun signal fort justifiant qu’on l’explore en priorité.
Une page orpheline — accessible uniquement depuis le sitemap XML et depuis aucun lien interne cliquable — a statistiquement beaucoup plus de risques de rester dans cet état. Le sitemap indique à Google qu’une URL existe ; il ne lui indique pas qu’elle compte.
D’où viennent les signaux qui manquent
Trois signaux pèsent particulièrement dans la décision d’explorer une URL neuve : le nombre de liens internes qui pointent vers elle depuis des pages déjà indexées, la fraîcheur et l’autorité perçue de ces pages sources, et la présence ou l’absence de la page dans un flux consulté régulièrement par le robot, comme la page d’accueil ou une page de catégorie à fort trafic.
Diagnostiquer une page bloquée
Avant de conclure à un manque de maillage, quelques vérifications rapides évitent de perdre du temps sur une fausse piste :
- Contrôler dans l’outil d’inspection d’URL de Search Console que la page n’a pas été explorée puis rejetée, ce qui orienterait vers un tout autre statut.
- Vérifier qu’aucune règle du fichier
robots.txtne décourage l’exploration du répertoire concerné. - Confirmer que la page est bien listée dans le sitemap avec la bonne date de
lastmod, générée par la fonction nativewp_sitemaps_get_server()de WordPress. - Rechercher, via l’opérateur
site:, si une page très proche en contenu n’existe pas déjà et n’absorbe pas la priorité d’exploration.
Corriger le maillage plutôt que forcer l’indexation
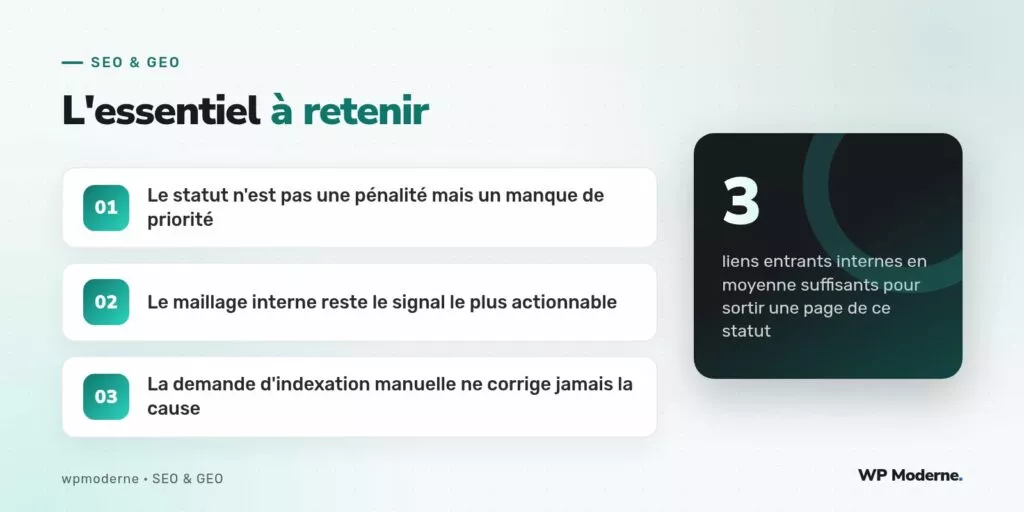
La tentation la plus courante consiste à utiliser la fonction « Demander l’indexation » de l’outil d’inspection d’URL. Elle fonctionne parfois, mais ne traite jamais la cause : sans lien entrant durable, la page retombera dans le même statut au prochain passage du robot, quelques semaines plus tard. La correction utile se joue dans le contenu du site lui-même.
Sur nos projets, ajouter manuellement trois liens contextuels vers la page neuve — depuis un article connexe déjà indexé, depuis une page de catégorie, et depuis un module de type « à lire aussi » — suffit dans la majorité des cas à faire sortir la page de ce statut en moins d’une semaine. Le filtre the_content permet d’automatiser ce type d’ajout pour les publications futures, en insérant un lien vers le dernier article publié dans la même catégorie.
Une page qui mérite d’être trouvée par un lecteur mérite tout autant d’être trouvée par un lien. Le sitemap ne remplace jamais un lien contextuel cliqué par un humain.
En résumé
« Découverte, actuellement non indexée » décrit un manque de priorité d’exploration, pas une erreur technique. Le sitemap ne suffit pas à convaincre Google qu’une page mérite une visite rapide : ce sont les liens internes, posés depuis des pages déjà reconnues, qui font cette démonstration. Avant de solliciter l’indexation manuelle, mieux vaut vérifier le maillage réel de la page et corriger ce qui, la plupart du temps, s’avère être la cause première.