wp post list --post_type=product --format=count renvoie 103 482. Face à ce chiffre, tout outil de crawl externe classique — même performant — met plusieurs jours à explorer l’intégralité du catalogue, et fausse une partie de ses résultats en cours de route à cause du contenu qui change pendant le crawl. Pour cartographier le maillage interne d’un site de cette taille, il est souvent plus rapide et plus fiable de lire directement dans la base de données plutôt que de simuler un navigateur.
Ce constat vient d’un projet e-commerce où le rapport de maillage attendu depuis un outil SaaS n’est jamais arrivé à terme avant l’expiration du quota mensuel de pages crawlées. La solution retenue a consisté à extraire les liens directement depuis le contenu stocké en base, sans jamais solliciter le serveur web.
Pourquoi le crawl HTTP classique échoue à cette échelle
Un crawler HTTP doit télécharger chaque page, attendre la réponse du serveur, parser le HTML rendu, puis suivre chaque lien découvert. Sur cent mille URL, même à dix requêtes par seconde en parallèle, l’opération dépasse largement l’heure et met une charge non négligeable sur l’hébergement — avec un risque réel de déclencher les protections anti-bot du serveur ou du CDN en cours de route.
La base de données WordPress contient pourtant déjà toute l’information nécessaire : chaque lien interne existe sous forme de balise <a href> dans le champ post_content, ou sous forme de référence d’ID dans les métadonnées d’un champ ACF de type relation. Il suffit de la lire une fois.
Extraire les liens directement depuis post_content
Le script ci-dessous s’exécute en tant que commande WP-CLI personnalisée. Il parcourt chaque contenu publié, extrait les URL internes présentes dans les balises <a> via une expression régulière simple, et les normalise pour ignorer les paramètres de tracking et le slash final.
WP_CLI::add_command( 'maillage:extraire', function() {
    global $wpdb;
    $posts = $wpdb->get_results(
        "SELECT ID, post_content FROM {$wpdb->posts}
         WHERE post_status = 'publish' AND post_type IN ('post','product')"
    );
    $liens = [];
    foreach ( $posts as $post ) {
        preg_match_all( '/href="([^"]+)"/', $post->post_content, $matches );
        foreach ( $matches[1] as $url ) {
            if ( strpos( $url, home_url() ) === 0 ) {
                $liens[ $post->ID ][] = untrailingslashit( strtok( $url, '?' ) );
            }
        }
    }
    file_put_contents( '/tmp/graphe-liens.json', wp_json_encode( $liens ) );
    WP_CLI::success( count( $liens ) . ' articles analysés.' );
} );
Sur le catalogue en question, cette commande s’exécute en un peu moins de quatre minutes en environnement de production, contre une exploration HTTP encore inachevée après plusieurs heures avec l’outil SaaS précédemment utilisé.
Repérer les pages orphelines par soustraction
Une fois le graphe construit, une page orpheline se définit simplement : c’est un ID publié qui n’apparaît dans la liste des cibles d’aucun autre article. Il suffit de comparer l’ensemble des ID publiés à l’ensemble des ID référencés comme destination dans le graphe.
- Charger la liste complète des ID publiés via
wp post list --format=ids - Construire l’ensemble des ID cibles à partir du fichier JSON généré
- Calculer la différence entre les deux ensembles
- Croiser le résultat avec les données de trafic de Search Console pour prioriser
Aller plus loin : pondérer les liens par position dans la page
Un lien placé dans le corps d’un article n’a pas le même poids qu’un lien de pied de page répété sur toutes les URL du site. Pour affiner l’analyse, le script peut être enrichi d’un second passage qui repère la position du lien dans le DOM rendu — via une lecture ciblée du contenu du bloc concerné plutôt que du HTML final. Sur un site construit avec l’éditeur de blocs, les blocs core/query et core/navigation se repèrent facilement dans le contenu stocké, ce qui permet de les exclure du calcul de maillage « éditorial » pour ne garder que les liens réellement choisis par un rédacteur.
Limites de la méthode
Cette approche ne capture pas les liens injectés dynamiquement par un plugin au moment du rendu, ni ceux ajoutés via un widget ou un template PHP en dehors du contenu éditorial. Pour une vision complète, il reste utile de croiser ce graphe avec un échantillon de crawl HTTP classique sur quelques centaines de pages représentatives, afin de vérifier que rien d’important n’échappe à l’analyse base de données.
En résumé
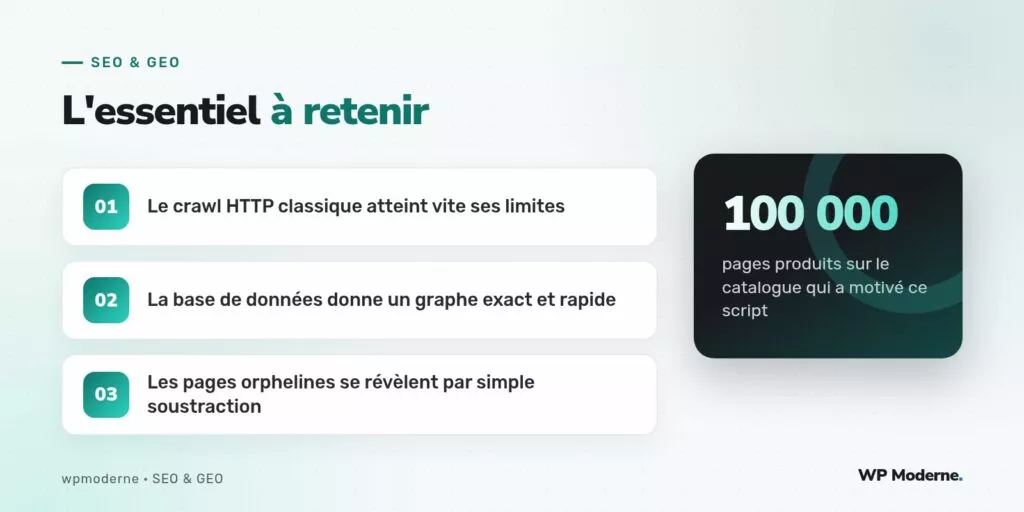
Sur un catalogue de cent mille pages, la base de données WordPress est souvent une source plus rapide et plus complète qu’un crawl HTTP pour cartographier le maillage interne. Le script présenté ici tient en une trentaine de lignes et s’exécute en quelques minutes, là où l’alternative SaaS demandait des jours et un budget de crawl externe conséquent. La méthode se généralise à tout site volumineux, à condition d’accepter ses limites sur les liens générés dynamiquement.