Sur un site où le balisage structuré s’est construit progressivement, au fil des besoins successifs, trois fonctions distinctes finissent souvent par contribuer au même bloc JSON-LD d’une fiche produit : l’une ajoutée pour le prix et la disponibilité au moment de l’installation de la boutique, une seconde pour les avis clients quand cette fonctionnalité est arrivée plus tard, une troisième pour les caractéristiques techniques ajoutées via des champs personnalisés. Chacune fonctionne correctement prise isolément. Ensemble, sans coordination, elles produisent fréquemment plusieurs balises <script type="application/ld+json"> sur la même page, ou pire, une seule balise dans laquelle une fonction écrase le travail de la précédente.
Cette recette s’adresse à un développeur backend qui doit consolider ce type de balisage éclaté, sans réécrire entièrement les fonctions existantes ni dépendre d’une extension tierce pour un besoin somme toute assez simple à centraliser proprement.
Le principe : un tableau partagé, fusionné une seule fois
Plutôt que chaque fonction n’écrive directement sa propre balise script, l’approche consiste à faire filtrer chacune un tableau PHP commun, représentant l’entité Product en construction, avant qu’un unique point d’encodage final ne transforme ce tableau complet en JSON-LD.
function ajouter_prix_disponibilite( $donnees, $post ) {
    $donnees['offers'] = array(
        '@type'         => 'Offer',
        'price'         => get_post_meta( $post->ID, 'prix', true ),
        'priceCurrency' => 'EUR',
        'availability'  => get_post_meta( $post->ID, 'stock', true )
            ? 'https://schema.org/InStock'
            : 'https://schema.org/OutOfStock',
    );
    return $donnees;
}
add_filter( 'monsite_product_schema', 'ajouter_prix_disponibilite', 10, 2 );
Ajouter les avis sans écraser le prix
function ajouter_avis_clients( $donnees, $post ) {
    $note_moyenne = get_post_meta( $post->ID, 'note_moyenne', true );
    $nombre_avis  = get_post_meta( $post->ID, 'nombre_avis', true );
    if ( $note_moyenne && $nombre_avis ) {
        $donnees['aggregateRating'] = array(
            '@type'       => 'AggregateRating',
            'ratingValue' => $note_moyenne,
            'reviewCount' => $nombre_avis,
        );
    }
    return $donnees;
}
add_filter( 'monsite_product_schema', 'ajouter_avis_clients', 20, 2 );
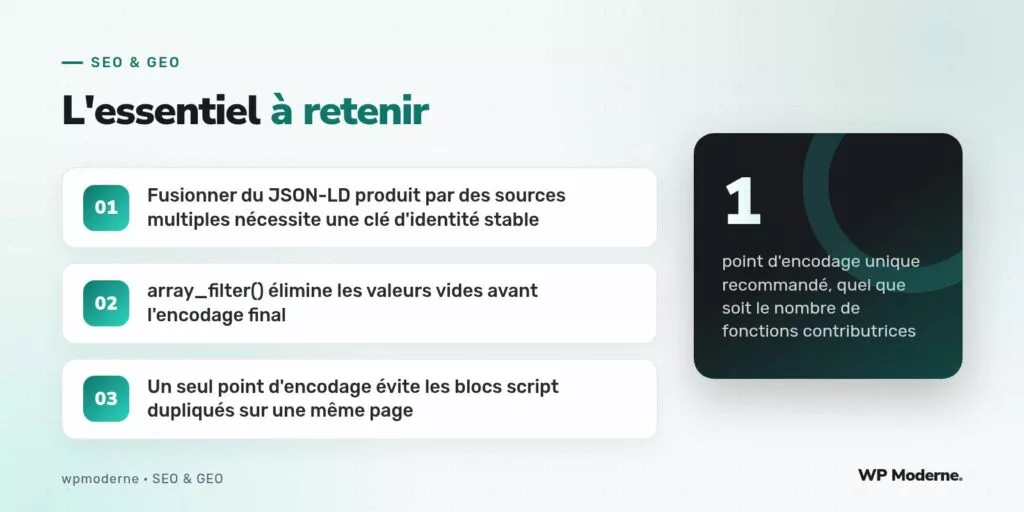
Chaque fonction s’accroche à une priorité distincte sur le même filtre monsite_product_schema, ce qui garantit un ordre d’exécution prévisible et évite qu’une fonction n’écrase par erreur une clé déjà renseignée par une autre, à condition que chacune écrive sous sa propre clé de premier niveau.
Nettoyer les valeurs vides avant l’encodage
Une caractéristique technique dont le champ personnalisé n’a pas été renseigné ne doit jamais apparaître comme une chaîne vide dans le JSON-LD final, ce qui produirait un balisage syntaxiquement valide mais sémantiquement trompeur. La fonction native array_filter(), appliquée juste avant l’encodage, retire ces entrées vides sans nécessiter de vérification manuelle dans chaque fonction contributrice :
function encoder_schema_produit( $post ) {
    $donnees = array(
        '@context' => 'https://schema.org',
        '@type'    => 'Product',
        'name'     => get_the_title( $post ),
    );
    $donnees = apply_filters( 'monsite_product_schema', $donnees, $post );
    $donnees = array_filter( $donnees );

    echo '<script type="application/ld+json">'
        . wp_json_encode( $donnees, JSON_UNESCAPED_SLASHES )
        . '</script>';
}
add_action( 'wp_footer', function() {
    if ( is_singular( 'product' ) ) {
        encoder_schema_produit( get_post() );
    }
} );
Vérifier le résultat consolidé
- Contrôler dans le code source qu’une seule balise
scriptde typeapplication/ld+jsonapparaît par fiche produit. - Passer l’URL dans l’outil de test de résultats enrichis de Google pour confirmer qu’aucune clé attendue par le type
Productne manque après filtrage. - Tester délibérément une fiche sans avis clients pour vérifier que la clé
aggregateRatingdisparaît proprement plutôt que d’apparaître vide.
Un seul point d’encodage, alimenté par plusieurs fonctions disciplinées, vaut toujours mieux que plusieurs points d’encodage qui s’ignorent mutuellement.
En résumé
Centraliser la construction du balisage JSON-LD autour d’un filtre partagé, plutôt que de laisser chaque fonction écrire sa propre balise script, élimine les doublons et les écrasements silencieux. Cette architecture s’étend facilement à de nouvelles sources de données futures, sans jamais toucher au point d’encodage final ni aux fonctions déjà en place.