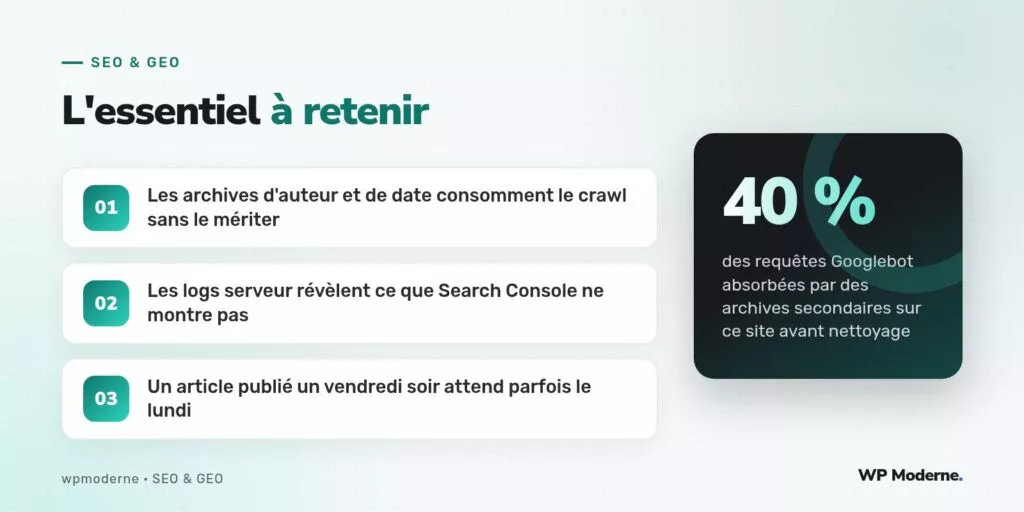
« Selon nos observations sur les logs serveur de Googlebot, environ 40 % des requêtes d’exploration se dirigeaient vers des archives de date et de tag plutôt que vers de nouveaux articles » : c’est le constat de départ d’un audit mené pour un média régional qui publiait entre quinze et vingt-cinq articles par jour, et dont certains ne se voyaient explorés par Googlebot que plusieurs jours après leur mise en ligne.
Le problème : un volume de pages qui dépasse la capacité d’exploration
Un site qui publie à ce rythme génère mécaniquement un volume de pages bien supérieur au nombre d’articles réellement rédigés : chaque article alimente une archive de catégorie, une archive de tag (souvent plusieurs par article), une archive d’auteur et une archive de date, à raison potentiellement de cinq à huit URL secondaires générées automatiquement pour chaque nouvel article publié. Google alloue à chaque site un budget d’exploration qui n’est pas infini, et ce budget se répartit entre toutes ces URL, y compris celles qui n’apportent aucune valeur éditoriale propre.
Le symptôme se confirme dans le rapport « Statistiques sur l’exploration » de Search Console, mais c’est l’analyse des logs serveur bruts qui révèle la répartition réelle, requête par requête, entre les différents types de pages explorées par Googlebot.
Analyser les logs pour quantifier le gaspillage
L’analyse a porté sur trente jours de logs serveur bruts, filtrés sur le user-agent Googlebot vérifié par résolution DNS inversée, puis classés par type d’URL :
grep "Googlebot" access.log | awk '{print $7}' \
  | sed -E 's#/(20[0-9]{2}/[0-9]{2}/[0-9]{2})/.*#/archive-date/#' \
  | sort | uniq -c | sort -rn | head -30
Ce classement a confirmé que les archives de date, générées automatiquement par WordPress pour chaque jour, mois et année de publication, représentaient à elles seules près d’un quart des requêtes Googlebot sur la période, pour des pages qui ne faisaient que lister des liens vers les articles déjà accessibles par ailleurs via la page d’accueil et les catégories.
Priorités d’action classées par gain estimé
À partir de ce classement, les actions ont été priorisées selon le volume de crawl récupérable :
- Passage des archives de date en
noindex, follow: elles restent explorables pour la découverte de liens, mais ne consomment plus de budget d’indexation propre. - Fusion des tags redondants ou trop proches sémantiquement, qui multipliaient le nombre d’archives sans réel intérêt de navigation.
- Réduction du nombre de flux RSS secondaires générés par défaut (par tag, par auteur), rarement consultés mais systématiquement explorés.
La désactivation de l’indexation des archives de date s’est faite via un filtre conditionnel dans l’extension SEO, plutôt qu’en modifiant le thème :
add_filter( 'wpseo_robots', function( $robots ) {
    if ( is_date() ) {
        return 'noindex, follow';
    }
    return $robots;
});
Le cas particulier du vendredi soir
Un article publié un vendredi soir attend parfois le lundi matin avant d’être exploré : ce décalage, observé sur ce média, provenait d’un pic de publication en fin de semaine qui saturait ponctuellement le budget de crawl quotidien alloué par Google, déjà en grande partie consommé par les archives secondaires évoquées plus haut. Une fois ce gaspillage réduit, le délai moyen d’exploration des nouveaux articles est passé de plusieurs heures à quelques dizaines de minutes, y compris pour les publications de fin de semaine.
Sur un site à publication quotidienne dense, chaque archive générée automatiquement doit justifier sa place dans l’index : à défaut, elle prélève silencieusement une part du budget d’exploration qui devrait revenir au contenu neuf.
En résumé
Un budget de crawl tendu, sur un site d’actualité à publication soutenue, se résout rarement en optimisant les articles eux-mêmes : il se résout en identifiant, via les logs serveur, les types de pages qui absorbent l’exploration sans apporter de valeur — archives de date, tags redondants, flux secondaires — et en les retirant méthodiquement de la compétition pour le budget d’exploration disponible.