« Indexed, though blocked by robots.txt » : ce statut, visible dans le rapport de couverture de Search Console, surprend à chaque première rencontre. Comment une page peut-elle être indexée si son exploration est explicitement interdite ? La réponse tient à une distinction que Google applique strictement entre explorer une page et savoir qu’elle existe.
Ce billet détaille les causes fréquentes de ce statut sur un site WordPress et la marche à suivre pour le corriger selon l’intention réelle derrière le blocage initial.
Comprendre la distinction entre exploration et indexation
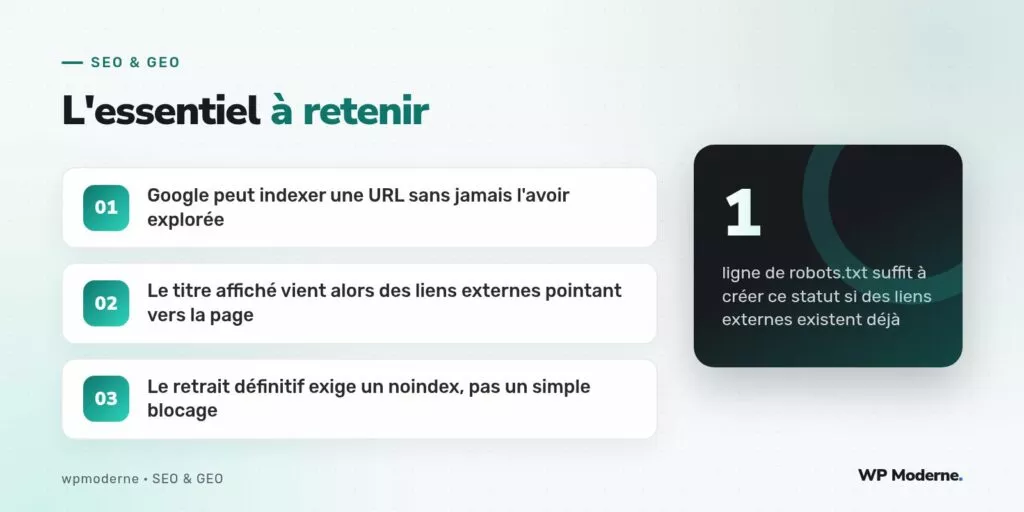
Le fichier robots.txt ne fait qu’une chose : il interdit l’exploration d’une URL par les robots qui le respectent. Il n’interdit pas son indexation. Si Google découvre l’existence de cette URL par un autre moyen, typiquement un lien externe qui pointe vers elle depuis un autre site, il peut l’indexer sans jamais avoir pu en lire le contenu, en se basant uniquement sur le texte du lien et le contexte environnant pour deviner un titre à afficher.
Le résultat visible dans les résultats de recherche est souvent un extrait générique du type « Aucune information n’est disponible pour cette page », avec un titre approximatif reconstitué à partir des ancres de lien.
Les causes fréquentes sur un site WordPress
Trois situations reviennent le plus souvent dans ce diagnostic. La première : une URL bloquée dans robots.txt dès sa création, par exemple un répertoire de test ou de prévisualisation, mais qui a fini par recevoir un lien externe involontaire, parfois généré automatiquement par un agrégateur de contenu ou un annuaire.
La deuxième cause concerne les pages issues d’un ancien système de gestion de contenu, bloquées après une migration vers WordPress, alors que des liens externes historiques continuent d’exister vers ces anciennes URL et que Google les redécouvre régulièrement.
La troisième, plus subtile, touche les sites récemment mis en cache par un service tiers : Google a pu explorer la page avant l’ajout de la ligne de blocage dans robots.txt, et le cache de l’index n’est pas encore purgé au moment où le blocage est détecté lors du prochain passage du robot.
Corriger selon l’intention réelle
La correction dépend entièrement de ce que l’on souhaite réellement pour cette URL. Si la page ne doit vraiment jamais apparaître dans les résultats, bloquer son exploration ne suffit pas : il faut au contraire l’autoriser à l’exploration et ajouter une balise meta name="robots" content="noindex" dans son <head>, pour que Google puisse constater le refus d’indexation en visitant réellement la page.
<meta name="robots" content="noindex, follow">Si à l’inverse la page doit être indexée normalement, il faut retirer la ligne de blocage correspondante dans robots.txt et vérifier, via l’outil d’inspection d’URL de Search Console, que l’exploration redevient possible.
Étapes de vérification après correction
- Tester la nouvelle configuration avec l’outil de test
robots.txtintégré à Search Console. - Soumettre l’URL corrigée via l’outil d’inspection pour accélérer la nouvelle exploration.
- Surveiller le rapport de couverture pendant deux à trois semaines, le statut ne se met pas à jour instantanément.
Sur les sites que nous suivons, on documente systématiquement l’intention derrière chaque ligne de
robots.txt: bloquer l’exploration et empêcher l’indexation ne sont pas la même demande, et confondre les deux est la source numéro un de ce statut.
En résumé
Ce statut contradictoire n’est pas un bug de Search Console, c’est le comportement documenté de Google face à un lien externe pointant vers une URL bloquée à l’exploration. La correction ne consiste jamais à ajouter du blocage supplémentaire, mais à choisir clairement entre laisser explorer avec un noindex, ou retirer purement et simplement le blocage.
