2021-01-07 : sur un réseau WordPress multisite hébergeant plusieurs centaines d’instances pour des clients d’agence, la question qui revient à chaque nouveau site ajouté est toujours la même : combien de temps Google va-t-il mettre à explorer correctement le nouveau venu, sachant que 499 autres sites se partagent déjà son attention ?
Le réseau au cœur de ce cas héberge cinq cents sites vitrines pour des indépendants et petites entreprises, tous sur le même WordPress multisite. Certains génèrent un trafic conséquent, d’autres n’ont pas été mis à jour depuis des mois. Le budget de crawl, invisible mais bien réel, ne se répartit pas équitablement entre les deux catégories.
Le problème : un sitemap racine qui noie tout
La configuration initiale de ce réseau exposait un seul sitemap au niveau du domaine principal, qui référençait indistinctement toutes les instances du multisite via des sous-répertoires. Cette approche a un effet pervers : Google traite le domaine comme une seule entité de crawl, et répartit son budget d’exploration sur l’ensemble sans distinguer les sites à fort enjeu commercial des sites quasi abandonnés.
Résultat observé sur trois mois de suivi : les sites les plus actifs, ceux dont le contenu change chaque semaine, n’étaient explorés qu’une fois tous les dix à quinze jours, un rythme largement insuffisant pour refléter rapidement leurs mises à jour dans les résultats de recherche.
L’architecture de sitemaps par instance
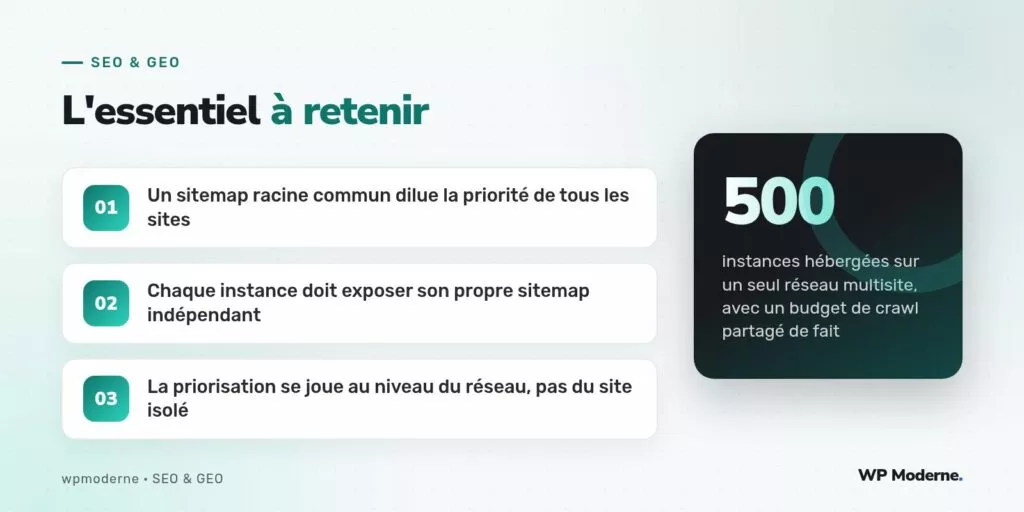
La restructuration a consisté à donner à chaque instance du multisite son propre sitemap indépendant, exposé à sa propre racine, plutôt que de tout centraliser :
reseau-agence.fr/
├── site-a.reseau-agence.fr/wp-sitemap.xml
├── site-b.reseau-agence.fr/wp-sitemap.xml
├── site-c.reseau-agence.fr/wp-sitemap.xml
└── ... (500 instances, chacune avec son sitemap propre)
Cette structure s’appuie sur le générateur de sitemap natif de WordPress, disponible depuis la version 5.5, activé indépendamment sur chaque site du réseau via son propre réglage de visibilité par moteur de recherche. Chaque instance est alors traitée par Google comme une entité de crawl distincte, avec son propre historique d’exploration.
Prioriser sans mentir à Google
La priorisation ne se joue pas dans les balises <priority> du sitemap, largement ignorées par Google depuis plusieurs années, mais dans des signaux plus fiables :
- La fréquence de soumission via l’API d’indexation ou le ping automatique, réservée aux sites à forte cadence de publication.
- Le maillage interne réel de chaque site : plus un site a de contenu correctement relié, plus il justifie un crawl fréquent aux yeux de Google.
- La désactivation pure et simple des sitemaps pour les instances client explicitement mises en pause ou en maintenance longue durée, afin de ne pas gaspiller de ressources de crawl sur du contenu figé.
Ce que révèlent les journaux serveur
L’analyse des journaux d’accès du serveur mutualisé, filtrée sur l’user-agent Googlebot, a confirmé l’hypothèse initiale : avant la restructuration, environ soixante-dix pour cent des requêtes de Googlebot se concentraient sur une vingtaine de sites parmi les cinq cents, souvent les plus anciens du réseau, sans rapport avec leur pertinence commerciale actuelle.
Sur ce type de réseau, on considère qu’un site laissé sans sitemap actif pendant plus de six mois ne mérite plus de budget de crawl dédié : mieux vaut le désactiver proprement que de laisser Google explorer du contenu figé au détriment des sites vivants.
En résumé
Sur un multisite de cette envergure, le budget de crawl ne se gère pas au niveau du réseau entier mais instance par instance, avec des sitemaps indépendants et une priorisation fondée sur des signaux réels d’activité plutôt que sur des déclarations statiques. La mutualisation technique de l’hébergement ne doit jamais se traduire par une mutualisation de la stratégie d’exploration.